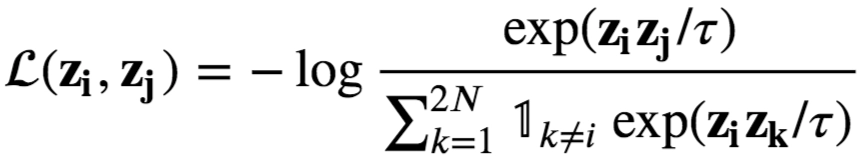z_i 는 반드시 anchor 이고 여기서 z_j 는 반드시 positive sample 이다. (NX-Xent loss 참고 Supervised NT-Xent loss (Khosla et al. 2020), let's first look at the self-supervised version of NT-Xent loss. NT-Xent is coined by Chen et al. 2020 in the SimCLR paper and is short for "normalized temperature scaled cross entropy loss‣”. It is a modification of the multi-class N-pair loss with addition of the temperature parameter (𝜏) to scale the cosine similarities. Chen et al. found that an appropriate temperature parameter can help the model learn from hard negatives. 도 마찬가지이다.)
언뜻 z_j 에 해당하는 것에 negative sample 를 넣어 더 일반화시켜도 되지 않을까? 하는 생각이 들 수 있지만,
잘 생각해보면 z_j 에 posive 가 들어가든 negative 가 들어가든 -log(a/b) 에서 분모 b 는 대체적으로 똑같을테고 분자인 a 만 변하는데, a/b=1 이어야 loss=0 이므로 Optimal 이다. 이 상태로 훈련을 시키는 것이다.
당초 취지가
 positive / (positive_all +
 negative_all) 가 1 에 가까워지록 교육
*방향 과 은 해당 요소가 어떻게 변화했으면 좋겠다는 우리의 바람이다.
인데 만약 negative 과 anchor 의 유사도가 분자에 들어간다면 아래와 같은 교육을 하게 된다.
negative / (positive_all + negative_all) 가 1 에 가까워지도록 교육
negative 은 증가해야 하는데 negative_all 은 감소해야 한다고? negative 은 negative_all 의 부분집합이다. 게다가 positive_all 은 증가하기를 바라야하는데 이 식에서는 감소하기를 바라므로 이건 노이즈이다.
 loss 를 해석할 때 이렇게 (참고3) 식의 요소를 각각, 귀납적으로(?) 해석해도 되는건가? 논문 (supervised contrastive loss ‣) 에서 이걸 역전파식으로 유도 (참고1) 하는 것이 나오던데, 이런 직관과 현실이 조금 다른 경우들이 왕왕 존재하는 것 같다. 해당 논문 (참고2) 을 참고해서 개념을 확실히 하는건 어떨까? 관련 의문 (참고4)
positive / (positive_all + negative_all) 가 1 에 가까워지록 교육
*방향 과 은 해당 요소가 어떻게 변화했으면 좋겠다는 우리의 바람이다.
인데 만약 negative 과 anchor 의 유사도가 분자에 들어간다면 아래와 같은 교육을 하게 된다.
negative / (positive_all + negative_all) 가 1 에 가까워지도록 교육
negative 은 증가해야 하는데 negative_all 은 감소해야 한다고? negative 은 negative_all 의 부분집합이다. 게다가 positive_all 은 증가하기를 바라야하는데 이 식에서는 감소하기를 바라므로 이건 노이즈이다.
loss 를 해석할 때 이렇게 (참고3) 식의 요소를 각각, 귀납적으로(?) 해석해도 되는건가? 논문 (supervised contrastive loss ‣) 에서 이걸 역전파식으로 유도 (참고1) 하는 것이 나오던데, 이런 직관과 현실이 조금 다른 경우들이 왕왕 존재하는 것 같다. 해당 논문 (참고2) 을 참고해서 개념을 확실히 하는건 어떨까? 관련 의문 (참고4)얘가 무조건 supervised 방식으로 사용되어야 한다는 것은 아님. 충분히 unsupervised 로도 사용 가능.