


취지
•
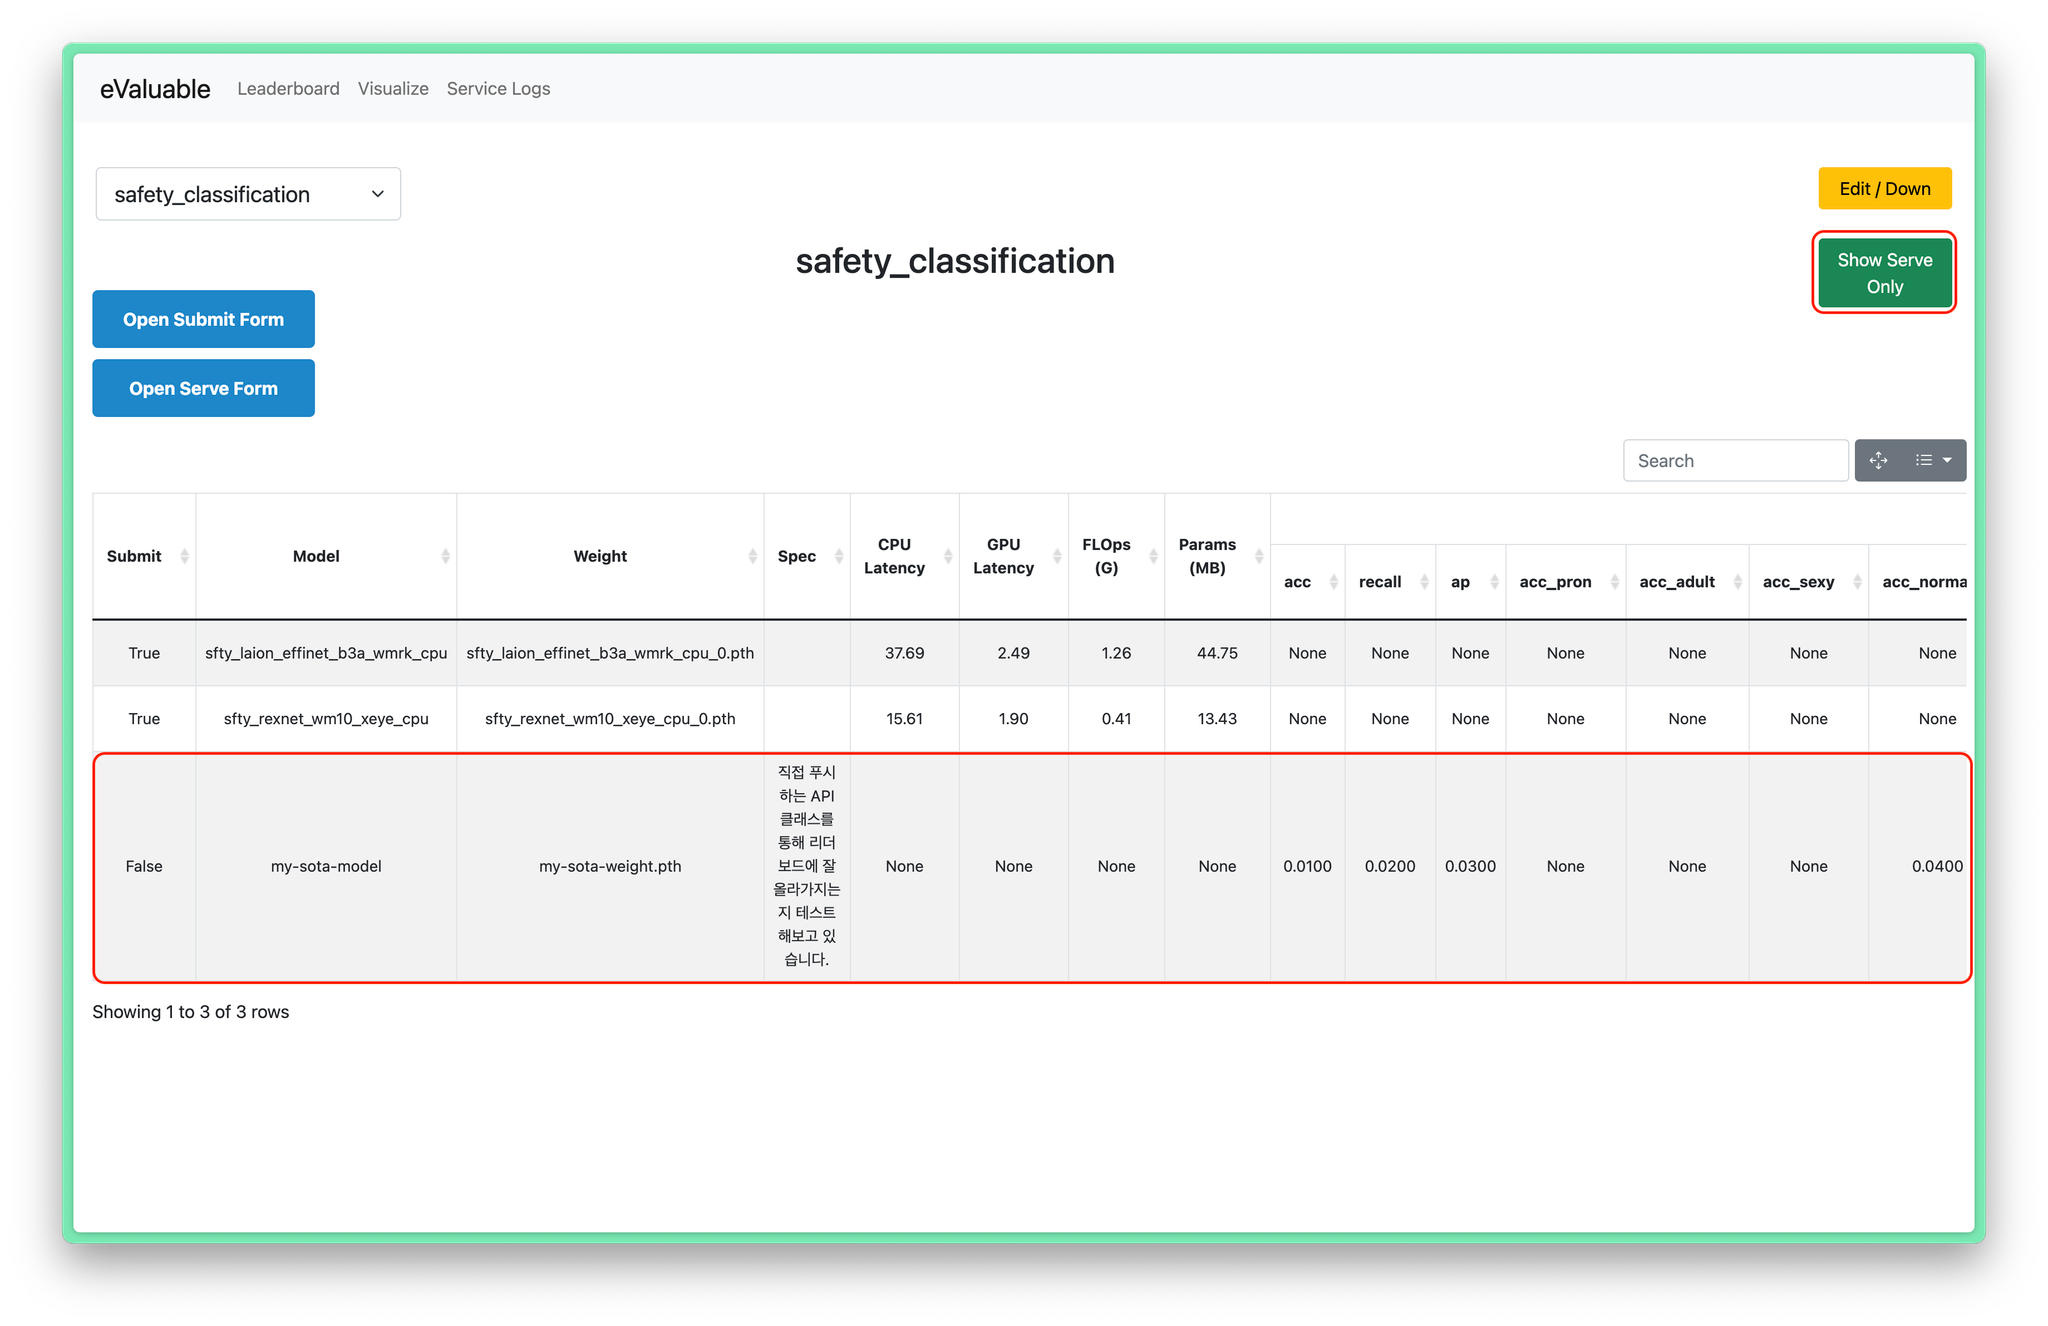
사실 evaluable 리더보드는 두 개입니다. 하나는 submit 리더보드고, 두번째는 show-all 버튼을 누르는 경우에만 보이는 리더보드입니다.
•
중요한 리더보드인 submit 리더보드에는 Web UI나 CLI 를 통해 파일을 제출하고 evaluable 서버에서 직접 평가를 한 경우에만 등록됩니다.
•
show-all 버튼을 눌렀을 때 나타나는 리더보드에는 외부에서 metric 을 연산한 뒤 결과만 등록하는 것이 가능해졌습니다.
•
이를 통해 매일매일 사용 가능한 메트릭 메모장 & 비교 표로서도 기능하게 하여 활용도를 높이면서도 중앙평가기로서 신뢰성을 잃지 않기를 기대합니다.
환경
가상환경을 준비하고 evaluable(≥1.4)를 설치합니다.
python3 -m pip install --upgrade \
--index-url=http://clops-pin.clova.ai/simple \
--trusted-host clops-pin.clova.ai \
evaluable
Python
복사
아래와 같이 클래스를 임포트하고 객체를 생성합니다.
from evaluable.modules.request.client.metric import EvaluableMetricHelper
helper = EvaluableMetricHelper(
task='sfty',
model_name='my-sota-model',
weight_name='my-sota-weight.pth',
author='test.janghoo',
dataset='xeye-test',
)
Python
복사
sfty 태스크 리더보드에 my-sota-model 라는 이름의 모델과 my-sota-weight.pth 라는 이름의 가중치를 가진 helper 객체를 정의했습니다.

이때 사용 가능한 태스크와 데이터셋 이름은 configurable 프로젝트를 통해 정의됩니다. configurable 저장소에 태스크와 데이터셋을 추가하고 evaluable 서버 관리자에게 서버 재시작을 부탁하세요.
어떤 모델을 등록할지 정했으니, 어떤 메트릭을 리더보드에 등록할지 정해야 합니다. 등록 가능한 메트릭을 출력해 봅니다.
print(helper.metrics)
Python
복사
출력 결과 예를 들어 아래와 같은 목록을 얻었다고 생각해 봅시다.
['acc', 'recall', 'ap', 'acc_pron', 'acc_adult', 'acc_sexy', 'acc_normal', 'recall_pron',
'recall_adult', 'recall_sexy', 'recall_normal', 'n_pos_gt', 'n_neg_gt', 'n_fp', 'n_fn']
Python
복사
위 메트릭 목록은 evaluable 리더보드에서 볼 수 있는 컬럼 목록과 동일합니다.

이제 그냥 helper 객체에 위 메트릭 중 일부를 골라 **kwargs 를 통해 전달해 주면 끝납니다. 리더보드에 등록됩니다.
helper.upload(
'직접 푸시하는 API 클래스를 통해 리더보드에 잘 올라가지는지 테스트해보고 있습니다.',
acc=0.11,
recall=0.22,
ap=0.33,
acc_normal=0.44,
)
Bash
복사
그러면 아래와 같이 리더보드에서 결과를 확인할 수 있습니다. 우상단의 Show All 버튼을 눌러 확인해보세요. 결과는 5분마다 동기화됩니다.
결과는 Nubes 를 통해 evaluable 서버로 전달됩니다. Nubes 와 연결 가능한 네트워크를 사용해주세요.